एआई बुनियादी ढांचे का परिदृश्य ख़तरनाक गति से विकसित हो रहा है। बुद्धिमान अनुप्रयोग बनाने वाली प्रत्येक टीम को एक मूलभूत प्रश्न का सामना करना पड़ता है: कौन सा डेटाबेस आपके AI स्टैक को रेखांकित करता है? उत्तर आपकी क्वेरी क्षमताओं, आपके परिनियोजन लचीलेपन, आपकी लागत संरचना और अंततः एआई सुविधाओं पर पुनरावृत्ति करने की आपकी क्षमता को निर्धारित करता है।
यह आलेख इनके बीच एक व्यापक तुलना प्रदान करता है नेबुलाडीबी - रस्ट में लिखा गया एक ओपन-सोर्स एआई-नेटिव हाइब्रिड डेटाबेस - और उभरती हुई श्रेणी एजेंट मेमोरी प्लेटफ़ॉर्म (मालिकाना SaaS सेवाएं AI एजेंटों के लिए लगातार मेमोरी, संदर्भ पुनर्प्राप्ति और अस्थायी स्थिति प्रदान करती हैं)। हम आपको सूचित निर्णय लेने में मदद करने के लिए वास्तुकला, सुविधाओं, एपीआई, तैनाती, लागत और उपयोग के मामलों की जांच करते हैं।
नेबुलाडीबी क्या है?
नेबुलाडीबी एक एआई-नेटिव हाइब्रिड डेटाबेस है जो दस्तावेज़ भंडारण, वेक्टर खोज, एआई एक्सटेंशन के साथ एसक्यूएल क्वेरी और स्ट्रीमिंग रिट्रीवल-ऑगमेंटेड जेनरेशन (आरएजी) को जोड़ता है - सभी एक ही रस्ट बाइनरी में। के अंतर्गत लाइसेंस प्राप्त है अपाचे-2.0, यह डॉकर छवियों, हेल्म चार्ट और कस्टम संसाधन परिभाषाओं के साथ एक पूर्ण कुबेरनेट्स ऑपरेटर के साथ एक स्व-होस्टेड समाधान के रूप में जहाज करता है।
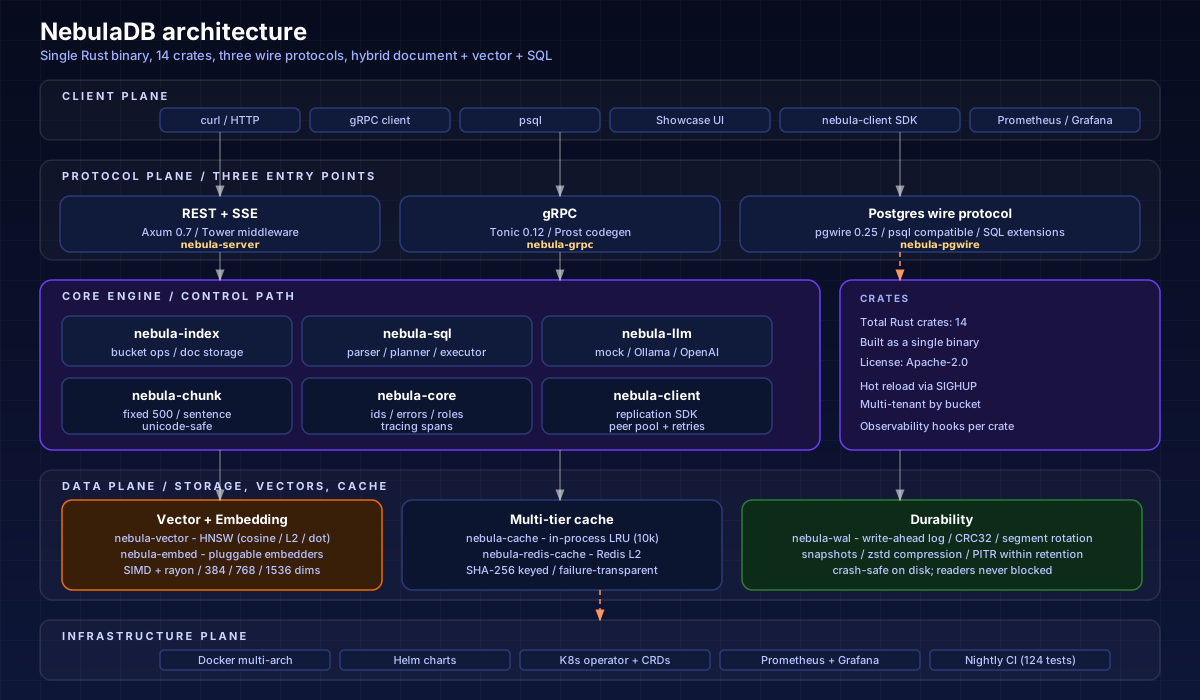
वास्तुकला पर प्रकाश डाला गया
NebulaDB को एक कार्यक्षेत्र के रूप में बनाया गया है 14 जंग लगे टोकरे, प्रत्येक एक विशिष्ट क्षमता के लिए जिम्मेदार:
- नीहारिका-सर्वर - मुख्य बाइनरी, एक्सम राउटर, टॉवर मिडलवेयर (ऑथ, रेट लिमिटिंग, सीओआरएस, कम्प्रेशन)
- नीहारिका-सूचकांक - बकेट-स्कोप्ड दस्तावेज़ और चंक स्टोरेज के साथ कोर टेक्स्टइंडेक्स
- नीहारिका-वेक्टर - कोसाइन, एल2 वर्ग और नकारात्मक डॉट-उत्पाद दूरी के साथ एचएनएसडब्ल्यू ग्राफ कार्यान्वयन; x86-64 (AVX2) और aarch64 (NEON) के लिए SIMD-अनुकूलित
- निहारिका-एसक्यूएल - SQL पार्सर (sqlparser-rs), प्लानर, और निष्पादक
semantic_match()औरvector_distance()कार्य - नेबुला-जीआरपीसी - टॉनिक-आधारित जीआरपीसी सेवाएं: दस्तावेज़, खोज और एआई
- नेबुला-pgwire - पोस्टग्रेज वायर प्रोटोकॉल हैंडलर (सरल क्वेरी प्रोटोकॉल, psql-संगत)
- नीहारिका-वाल - CRC32 अखंडता जांच, सेगमेंट रोटेशन, स्नैपशॉट समर्थन और zstd संपीड़न के साथ राइट-फ़ॉरवर्ड लॉग
- नीहारिका-एम्बेड - मॉक और ओपनएआई-संगत कार्यान्वयन के साथ प्लग करने योग्य एम्बेडर विशेषता
- नीहारिका-एलएलएम - मॉक, ओलामा और ओपनएआई बैकएंड के साथ एलएलएम क्लाइंट विशेषता
- नीहारिका-खंड - दस्तावेज़ खंडन रणनीतियाँ: निश्चित आकार (500 वर्ण, 50-चार ओवरलैप) और वाक्य-आधारित
- नीहारिका-कैश - इन-प्रोसेस एलआरयू एम्बेडिंग कैश (10,000 प्रविष्टियाँ डिफ़ॉल्ट)
- नेबुला-रेडिस-कैश - रेडिस-समर्थित L2 एम्बेडिंग कैश (SHA-256 कुंजीयुक्त, विफलता-पारदर्शी)
- नीहारिका-कोर - साझा प्रकार: आईडी, नेबुला एरर, नोडरोल एनम
- नीहारिका-ग्राहक - क्रॉस-रीजन प्रतिकृति के लिए एसडीके
तीन नेटवर्क प्रोटोकॉल
NebulaDB एक ही प्रक्रिया से एक साथ तीन प्रोटोकॉल पेश करता है:
- बाकी + एसएसई (एक्सम 0.7) - पूर्ण सीआरयूडी, सिमेंटिक सर्च, एसक्यूएल क्वेरीज़, सर्वर-सेंटेड इवेंट्स के साथ आरएजी स्ट्रीमिंग, प्रोमेथियस मेट्रिक्स, एडमिन ऑपरेशंस
- जीआरपीसी (टॉनिक 0.12) - आरएजी स्ट्रीमिंग के साथ दस्तावेज़, खोज और एआई सेवाएं
- पोस्टग्रेस वायर प्रोटोकॉल (पीजीवायर 0.25) - एआई एक्सटेंशन सहित पूर्ण एसक्यूएल बोली का समर्थन करने वाला सरल क्वेरी प्रोटोकॉल; के साथ जुड़ें
psql
एजेंट मेमोरी प्लेटफ़ॉर्म क्या हैं?
एजेंट मेमोरी प्लेटफ़ॉर्म एक नई श्रेणी है मालिकाना SaaS सेवाएँ एआई एजेंटों के लिए सतत स्मृति और संदर्भ अवसंरचना प्रदान करने के लिए डिज़ाइन किया गया है। वे आम तौर पर विशेषता रखते हैं:
- अस्थायी ज्ञान रेखांकन - संस्करणित इतिहास के साथ अपरिवर्तनीय खाता-आधारित स्थिति
- ग्राफ ट्रैवर्सल - केवल समानता खोज के बजाय मल्टी-हॉप संबंध प्रश्न
- साझा संदर्भ परतें - बहु-एजेंट बेड़े के लिए समन्वय आदिम
- प्रबंधित बुनियादी ढाँचा - एंटरप्राइज सेल्फ-होस्ट विकल्पों के साथ मल्टी-टेनेंट SaaS
- REST API और भाषा SDK - HTTP और Python/JS क्लाइंट के माध्यम से प्राथमिक पहुंच
पहुंच आम तौर पर आमंत्रण-आधारित या गेटेड होती है, जिसमें मूल्य निर्धारण भिन्न-भिन्न होता है $249/माह को $5,000+/महीना उद्यम स्तरों के लिए. अंतर्निहित कार्यान्वयन बंद-स्रोत हैं।
आमने-सामने तुलना
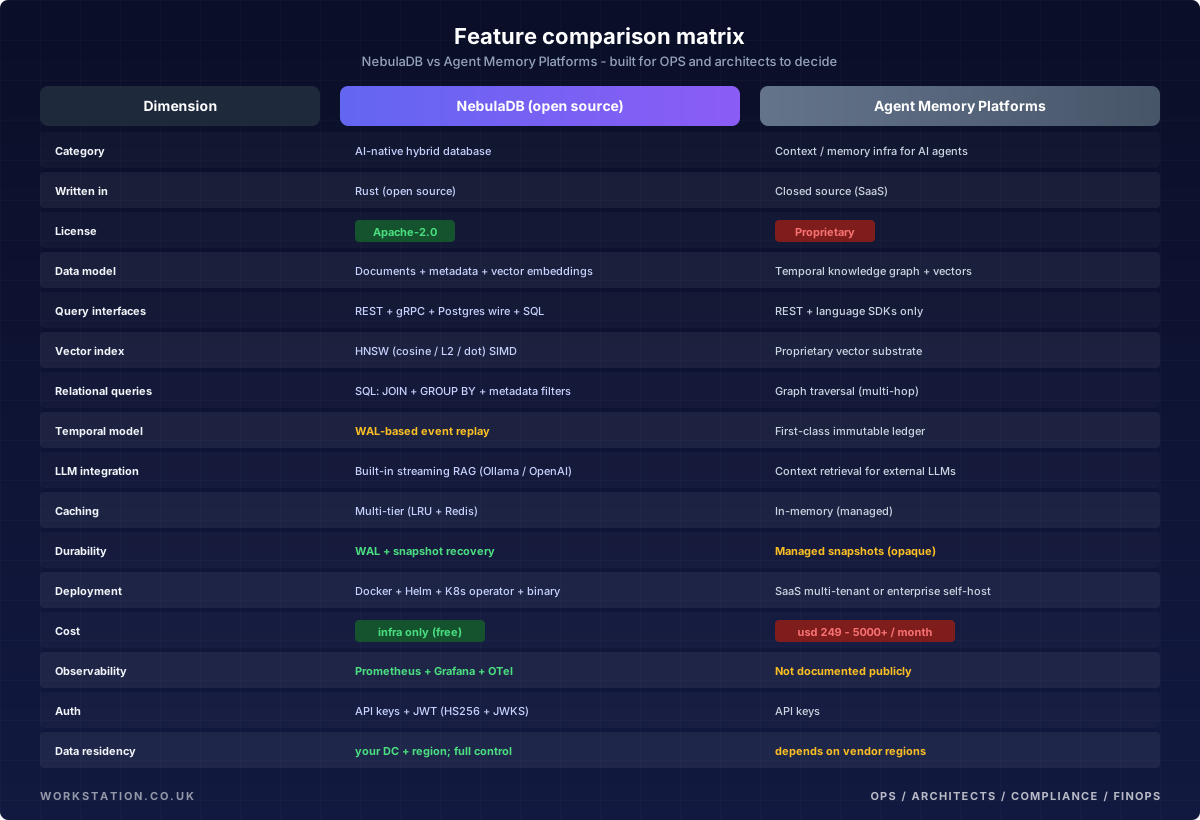
विस्तृत आयाम विश्लेषण
डेटा मॉडल
नेबुलाडीबी दस्तावेज़ों को समृद्ध मेटाडेटा (मनमाना JSON) और वेक्टर एम्बेडिंग के साथ बकेट में संग्रहीत करता है। दस्तावेज़ों को संरक्षित क्रम के साथ सर्वर-साइड पर खंडित किया जा सकता है। यह मॉडल स्वाभाविक रूप से ज्ञान के आधारों, दस्तावेज़ कॉर्पोरा और आरएजी पाइपलाइनों को मैप करता है जहां आपको एक सिस्टम में अंतर्ग्रहण, खोज और उत्पादन करने की आवश्यकता होती है।
प्रबंधित प्लेटफ़ॉर्म आमतौर पर इसका उपयोग करते हैं अस्थायी ज्ञान ग्राफ एक वेक्टर सब्सट्रेट के साथ - समय के साथ एजेंट स्थिति कैसे विकसित होती है, इस पर नज़र रखने के लिए अनुकूलित। यह मॉडल संवादात्मक एजेंटों में उत्कृष्ट है, जिन्हें यह याद रखने की आवश्यकता है कि उपयोगकर्ता ने पिछले महीने बनाम अब क्या पसंद किया है।
क्वेरी इंटरफ़ेस
नेबुलाडीबी चार क्वेरी इंटरफ़ेस (आरईएसटी, जीआरपीसी, पोस्टग्रेज वायर, कस्टम एसक्यूएल) टीमों को लचीलापन देते हैं, कोई प्रबंधित प्लेटफ़ॉर्म मेल नहीं खाता। आपके डेटा इंजीनियर उपयोग करते हैं psql तदर्थ विश्लेषण के लिए. आपकी माइक्रोसर्विसेज कम-विलंबता खोज के लिए जीआरपीसी को कॉल करती हैं। RAG स्ट्रीमिंग के लिए आपका फ्रंटएंड REST हिट करता है। सभी एक ही इंडेक्स पर आते हैं - एक बग फिक्स, एक फीचर एडिशन हर जगह सामने आता है।
प्रबंधित प्लेटफ़ॉर्म REST API और भाषा SDK प्रदान करते हैं - सरल पुनर्प्राप्ति के लिए पर्याप्त, लेकिन कोई SQL विश्लेषण नहीं, कोई पोस्टग्रेज़ संगतता नहीं, और कोई gRPC नहीं।
वेक्टर सूचकांक
नेबुलाडीबी लागू करता है HNSW (पदानुक्रमित नौगम्य लघु संसार) तीन दूरी मेट्रिक्स (कोसाइन, एल 2 वर्ग, नकारात्मक डॉट-उत्पाद), सिमडी-अनुकूल ऑटो-वेक्टराइजेशन, रेयान-आधारित समानता, और ग्राफ़ कनेक्टिविटी को संरक्षित करने वाले नरम विलोपन के साथ रस्ट में स्क्रैच से। आप इंडेक्स का निरीक्षण और ट्यून कर सकते हैं क्योंकि यह ओपन-सोर्स है।
प्रबंधित प्लेटफ़ॉर्म मालिकाना वेक्टर सबस्ट्रेट्स का उपयोग करते हैं - आप अपने उत्पादन सिस्टम का समर्थन करने वाले पुनर्प्राप्ति एल्गोरिदम का निरीक्षण, ट्यून या समझ नहीं सकते हैं।
एआई एक्सटेंशन के साथ एसक्यूएल
यह एक NebulaDB विभेदक है जिसका प्रबंधित प्लेटफ़ॉर्म में कोई समकक्ष नहीं है। SQL इंजन समर्थन करता है:
-- Semantic search with metadata filtering
SELECT * FROM knowledge_base
WHERE semantic_match(content, 'Kubernetes deployment patterns')
  AND region = 'eu-west-1'
ORDER BY score DESC
LIMIT 10;

-- Analytics over vector corpus
SELECT department, COUNT(*), AVG(score)
FROM documents
WHERE semantic_match(content, 'quarterly revenue')
GROUP BY department;

-- Cross-bucket JOIN with semantic retrieval
SELECT a.title, b.summary
FROM articles a
INNER JOIN summaries b ON a.doc_id = b.ref_id
WHERE semantic_match(a.content, 'machine learning ops');
प्रबंधित प्लेटफ़ॉर्म ग्राफ़ ट्रैवर्सल क्वेरीज़ प्रदान करते हैं - संबंध-जागरूक पुनर्प्राप्ति के लिए शक्तिशाली, लेकिन आप ग्रुप बाय एग्रीगेट्स, जॉइन नहीं चला सकते हैं, या संरचित एसक्यूएल एनालिटिक्स के साथ सिमेंटिक खोज को संयोजित नहीं कर सकते हैं।
एलएलएम एकीकरण और आरएजी
NebulaDB के पास है अंतर्निहित स्ट्रीमिंग RAG के माध्यम से /api/v1/ai/rag समापनबिंदु. कब stream=true, यह सर्वर-भेजे गए ईवेंट लौटाता है:
contextघटनाएँ - एलएलएम उत्पन्न होने से पहले वितरित किए गए स्कोर के साथ भाग प्राप्त किए गएanswer_deltaघटनाएँ - एलएलएम से स्ट्रीमिंग टोकन (ओलामा या ओपनएआई-संगत)doneघटना - खंड गणना और मॉडल जानकारी के साथ पूर्णता मार्कर
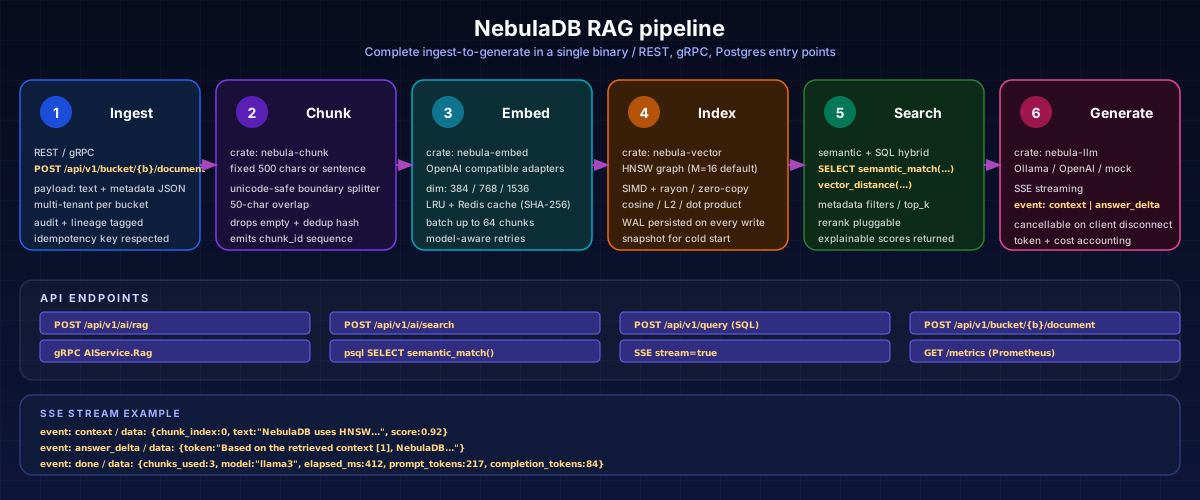
प्रबंधित प्लेटफ़ॉर्म प्रदान करते हैं संदर्भ पुनर्प्राप्ति - वे प्रासंगिक भाग लौटाते हैं, लेकिन आपको स्वयं एक बाहरी एलएलएम कॉल करना होगा। विलंबता और परिचालन जटिलता को जोड़ते हुए पाइपलाइन को दो सेवाओं में विभाजित किया गया है।
कैशिंग
नेबुलाडीबी बहु-स्तरीय एम्बेडिंग कैश एक महत्वपूर्ण प्रदर्शन लाभ है:
- एल1: प्रक्रियाधीन एलआरयू - डिफ़ॉल्ट रूप से 10,000 प्रविष्टियाँ, शून्य-प्रतिलिपि पुनर्प्राप्ति
- एल2: रेडिस - SHA-256 कुंजी प्रविष्टियों के साथ वैकल्पिक वितरित कैश; विफलता-पारदर्शी (अगर रेडिस डाउन है तो शानदार गिरावट)
- SQL परिणाम कैश - 30-सेकंड टीटीएल के साथ 512 प्रविष्टियाँ, डुप्लिकेट सिमेंटिक पुनर्प्राप्ति को समाप्त करती हैं
कैश कुंजियों का उपयोग SHA-256(model || 0x00 || text) क्रॉस-मॉडल टकराव को रोकने के लिए। बैचिंग परत विभाजन कैश एक ही पास में चूक से हिट हो जाता है, जिससे अपस्ट्रीम एम्बेडिंग एपीआई कॉल कम हो जाती है।
प्रबंधित प्लेटफ़ॉर्म आंतरिक रूप से कैशिंग को संभालते हैं - आपके पास कैश हिट दरों में कोई दृश्यता नहीं है, कैश आकार को ट्यून करने की कोई क्षमता नहीं है, और निष्कासन नीतियों पर कोई नियंत्रण नहीं है।
स्थायित्व
नेबुलाडीबी राइट-अहेड लॉग (वाल) क्रैश-सुरक्षित स्थायित्व प्रदान करता है:
- बिनकोड एन्कोडिंग के साथ प्रति रिकॉर्ड 8-बाइट हेडर (लंबाई + सीआरसी32)।
- जब फ़ाइलें कॉन्फ़िगर आकार से अधिक हो जाती हैं तो सेगमेंट रोटेशन
- संग्रहीत वेक्टर हल हो गए हैं - पुनर्प्राप्ति के लिए एम्बेडर को ऑनलाइन होने की आवश्यकता नहीं है
- Zstd कम्प्रेशन के साथ पॉइंट-इन-टाइम रिकवरी के लिए स्नैपशॉट समर्थन
- वाल कॉम्पैक्शन स्नैपशॉट से पुनर्निर्माण करके डिस्क को पुनः प्राप्त करता है
लीडर/फ़ॉलोअर प्रतिकृति टोपोलॉजी क्रॉस-नोड सिंक्रोनाइज़ेशन के लिए gRPC वाल सदस्यता का उपयोग करती है, जिसमें सभी तीन प्रोटोकॉल परतों (REST: 409, gRPC: FAILED_PRECONDITION, pgwire: SQLSTATE 25006) पर फॉलोअर राइट गार्ड लागू होते हैं।
तैनाती और संचालन
NebulaDB सबसे अधिक परिनियोजन लचीलापन प्रदान करता है:
- एकल बाइनरी - डाउनलोड करें और चलाएं
- डोकर - डॉकर हब पर मल्टी-आर्क छवियां (linux/amd64 + linux/arm64), गैर-रूट उपयोगकर्ता (UID 10001)
- डॉकर कम्पोज़ - ओलामा, रेडिस, प्रोमेथियस, ग्राफाना के साथ पूर्ण स्टैक
- हेल्म चार्ट - सर्वर, शोकेस यूआई, वैकल्पिक रेडिस सबचार्ट, प्रोमेथियस ऑपरेटर के लिए सर्विस मॉनिटर
- कुबेरनेट्स ऑपरेटर - सीआरडी:
NebulaCluster,NebulaBucket,NebulaRebalance; प्रवेश वेबहुक; अपग्रेड से पहले स्वचालित स्नैपशॉट और वाल संघनन
प्रबंधित प्लेटफ़ॉर्म SaaS (मल्टी-टेनेंट) हैं जिनमें एंटरप्राइज़ सेल्फ-होस्ट एक अपसेल टियर के रूप में है। आप परिचालन सुविधा के लिए परिनियोजन लचीलेपन का व्यापार करते हैं।
अवलोकनीयता
नेबुलाडीबी में शामिल हैं उत्पादन-ग्रेड अवलोकनशीलता बॉक्स से बाहर:
- प्रोमेथियस-संगत
/metricsसमापनबिंदु - डॉकर कंपोज़ स्टैक में पूर्व-निर्मित ग्राफाना डैशबोर्ड
- ट्रेसिंग एकीकरण (ट्रेसिंग क्रेट के माध्यम से अवधि-आधारित)
- SSE लॉग स्ट्रीम पर
/admin/logs/streamविन्यास योग्य स्तर के साथ - स्वास्थ्य जांच पर
/healthzसूचकांक आँकड़ों के साथ
प्रबंधित प्लेटफ़ॉर्म सार्वजनिक रूप से अपनी अवलोकन संबंधी विशेषताओं का दस्तावेज़ीकरण नहीं करते हैं। आप कैश प्रदर्शन, क्वेरी विलंबता वितरण और सूचकांक स्वास्थ्य पर ध्यान नहीं दे रहे हैं।
लागत
नेबुलाडीबी है निःशुल्क. Apache-2.0 लाइसेंस प्राप्त, स्व-होस्टेड, कोई उपयोग-आधारित मूल्य निर्धारण नहीं, कोई सीट सीमा नहीं, कोई फीचर गेट नहीं। आपकी एकमात्र लागत वह बुनियादी ढांचा है जिस पर आप इसे चलाते हैं।
प्रबंधित प्लेटफ़ॉर्म प्रारंभ होते हैं $249/माह और पैमाने पर $5,000+/महीना. एआई उत्पाद पर पुनरावृत्ति करने वाले स्टार्टअप के लिए, आपके द्वारा एप्लिकेशन कोड की एक पंक्ति लिखने से पहले यह $3,000-$60,000/वर्ष है।
एपीआई और डेवलपर अनुभव
दस्तावेज़ अंतर्ग्रहण (ऑटो-चंकिंग के साथ)
curl -X POST http://localhost:8080/api/v1/bucket/knowledge/document \
  -H "Authorization: Bearer $NEBULA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "doc_id": "arch-guide-001",
    "text": "NebulaDB uses HNSW for approximate nearest neighbor search...",
    "metadata": {"department": "engineering", "region": "eu-west-1"}
  }'
अर्थ संबंधी खोज
curl -X POST http://localhost:8080/api/v1/ai/search \
  -H "Authorization: Bearer $NEBULA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "query": "How does NebulaDB handle vector indexing?",
    "bucket": "knowledge",
    "top_k": 5
  }'
स्ट्रीमिंग आरएजी
curl -N http://localhost:8080/api/v1/ai/rag \
  -H "Authorization: Bearer $NEBULA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "query": "Explain the NebulaDB caching architecture",
    "bucket": "knowledge",
    "top_k": 3,
    "stream": true
  }'
एआई एक्सटेंशन के साथ एसक्यूएल (पीएसक्यूएल के माध्यम से)
psql -h localhost -p 5433

SELECT title, score FROM articles
WHERE semantic_match(content, 'Kubernetes deployment patterns')
  AND region = 'eu-west-1'
ORDER BY score DESC
LIMIT 10;
केस मैपिंग का उपयोग करें
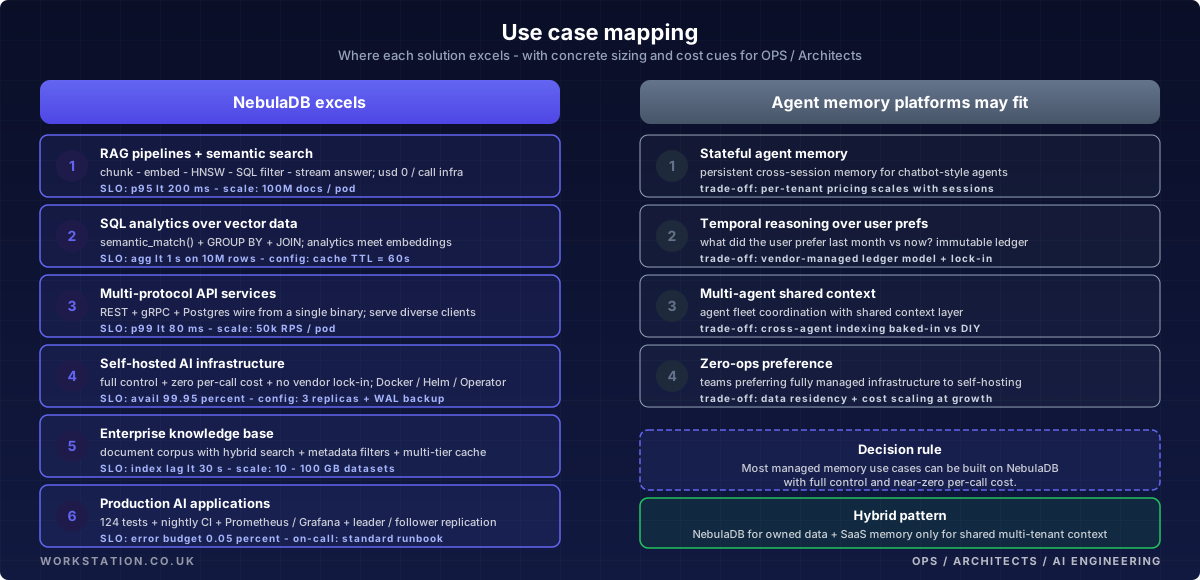
NebulaDB Excels के लिए
- आरएजी पाइपलाइन और सिमेंटिक खोज - एक ही बाइनरी में संपूर्ण इनजेस्ट-टू-जेनरेट पाइपलाइन अलग-अलग एम्बेडिंग, इंडेक्सिंग और जेनरेशन सेवाओं को एक साथ जोड़ने की आवश्यकता को समाप्त कर देती है।
- वेक्टर डेटा पर SQL एनालिटिक्स - कोई अन्य उपाय आपको चलने नहीं देता
GROUP BY departmentशब्दार्थ रूप से पुनर्प्राप्त दस्तावेज़ों पर। यह एनालिटिक्स उपयोग के मामलों को अनलॉक करता है जो केवल-पुनर्प्राप्ति प्लेटफ़ॉर्म के साथ असंभव हैं। - मल्टी-प्रोटोकॉल एपीआई सेवाएँ - विविध ग्राहक आवश्यकताओं (वेब फ्रंटएंड, माइक्रोसर्विसेज, डेटा इंजीनियर) वाली टीमें एक ही इंडेक्स के खिलाफ REST, gRPC और पोस्टग्रेज वायर प्रोटोकॉल का उपयोग कर सकती हैं।
- स्व-होस्टेड एआई इन्फ्रास्ट्रक्चर - डेटा रेजिडेंसी, सुरक्षा नीतियों और स्केलिंग पर पूर्ण नियंत्रण। Apache-2.0 लाइसेंसिंग के साथ शून्य विक्रेता लॉक-इन।
- ज्ञानकोष और दस्तावेज़ खोज - सिमेंटिक समानता और मेटाडेटा फ़िल्टर के संयोजन वाली हाइब्रिड खोज के साथ एंटरप्राइज़ दस्तावेज़ कॉर्पोरा।
- उत्पादन एआई अनुप्रयोग - 124 परीक्षणों, रात्रिकालीन सीआई, मल्टी-आर्क डॉकर छवियों, हेल्म चार्ट, एक कुबेरनेट्स ऑपरेटर और प्रोमेथियस/ग्राफाना अवलोकन क्षमता के साथ, नेबुलाडीबी उत्पादन के लिए तैयार है।
प्रबंधित प्लेटफ़ॉर्म उपयुक्त हो सकते हैं
- स्टेटफुल एजेंट मेमोरी - चैटबॉट-शैली एआई एजेंटों के लिए लगातार क्रॉस-सेशन मेमोरी जहां अस्थायी स्थिति प्राथमिक आवश्यकता है।
- अस्थायी तर्क — जब "उपयोगकर्ता ने पिछले महीने क्या पसंद किया?" एक मुख्य क्वेरी पैटर्न है और एक अपरिवर्तनीय खाता बही परक्राम्य नहीं है।
- मल्टी-एजेंट साझा संदर्भ - अंतर्निहित साझा संदर्भ परतों के साथ एजेंट बेड़े का समन्वय।
- जीरो-ऑप्स टीमें - टीमें जो पूरी तरह से प्रबंधित बुनियादी ढांचे को प्राथमिकता देती हैं और लागत और विक्रेता लॉक-इन ट्रेड-ऑफ को स्वीकार करने को तैयार हैं।
यह ध्यान देने योग्य है कि कई प्रबंधित प्लेटफ़ॉर्म उपयोग के मामले भी नेबुलाडीबी पर बनाए जा सकते हैं - वाल-आधारित इवेंट रीप्ले अस्थायी क्षमताएं प्रदान करता है, और एक्स्टेंसिबल आर्किटेक्चर कस्टम एजेंट मेमोरी परतों का समर्थन करता है।
निर्णय रूपरेखा
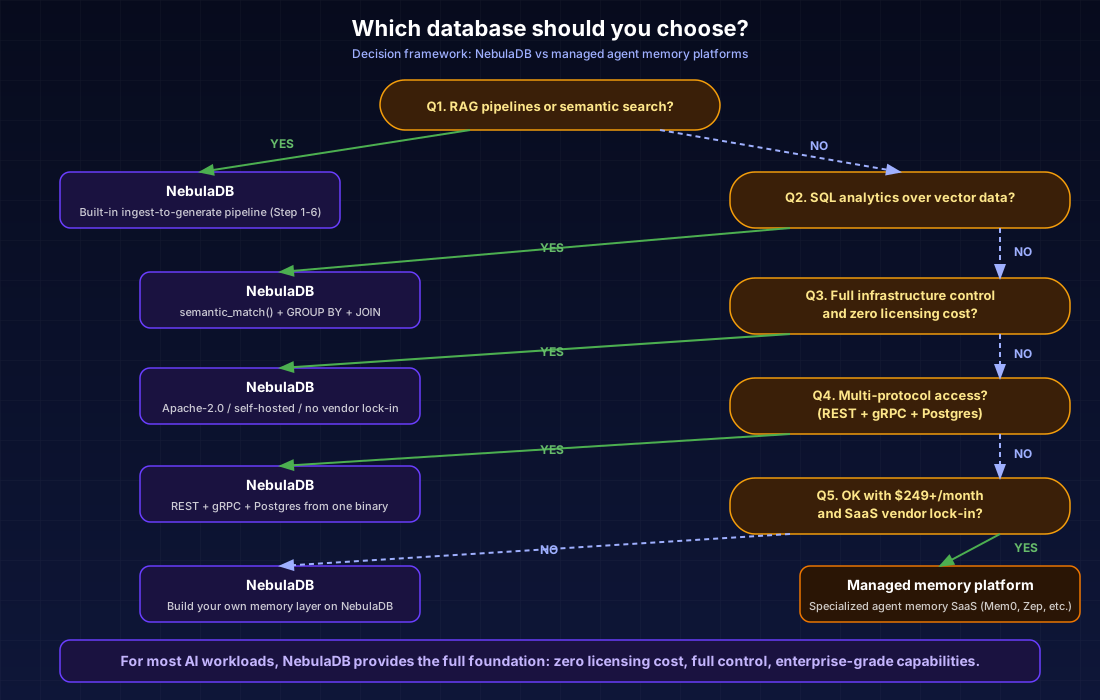
परिपक्वता और उत्पादन तत्परता
NebulaDB मजबूत इंजीनियरिंग प्रथाओं को प्रदर्शित करता है:
- 124 यूनिट परीक्षण क्लिप्पी-क्लीन रस्ट स्टेबल के साथ कार्यक्षेत्र में
- एकीकरण परीक्षण सुइट्स REST CRUD, RAG स्ट्रीमिंग, pgwire SQL, प्रोमेथियस मेट्रिक्स और लोड परीक्षण को कवर करना (60 समवर्ती अनुरोध, p95 <750ms)
- रात्रिकालीन सीआई 02:00 यूटीसी पर विन्यास योग्य ओलामा मॉडल के साथ
- मल्टी-आर्क डॉकर बनाता है मुख्य पुश और सेवर टैग पर
- संपत्ति आधारित परीक्षण मानदंड के माध्यम से प्रॉपटेस्ट और बेंचमार्क के माध्यम से
प्रबंधित प्लेटफ़ॉर्म आम तौर पर आमंत्रण-आधारित पहुंच, सीमित सार्वजनिक दस्तावेज़ीकरण और कोई अवलोकन योग्य सीआई या परीक्षण प्रथाओं के साथ प्रारंभिक चरण के SaaS होते हैं।
निष्कर्ष
एआई वर्कलोड के विशाल बहुमत के लिए - आरएजी पाइपलाइन, सिमेंटिक खोज, दस्तावेज़ पुनर्प्राप्ति, एम्बेडिंग पर एसक्यूएल एनालिटिक्स, ज्ञान आधार - NebulaDB पूर्ण बुनियादी ढांचे के नियंत्रण के साथ शून्य लागत पर एंटरप्राइज़-ग्रेड क्षमताएं प्रदान करता है. इसका रस्ट फाउंडेशन मेमोरी सुरक्षा और प्रदर्शन सुनिश्चित करता है। तीन-प्रोटोकॉल आर्किटेक्चर का मतलब है कि आपका पूरा संगठन अपने पसंदीदा इंटरफ़ेस के माध्यम से समान डेटा तक पहुंच सकता है। और कुबेरनेट्स ऑपरेटर, वाल स्थायित्व, और प्रोमेथियस अवलोकनशीलता इसे उत्पादन के लिए तैयार करती है।
एजेंट मेमोरी प्लेटफ़ॉर्म एक संकीर्ण क्षेत्र की सेवा करते हैं: टीमें स्टेटफुल कन्वर्सेशनल एजेंटों का निर्माण करती हैं जिन्हें बॉक्स से बाहर अस्थायी तर्क की आवश्यकता होती है और वे अपने स्वयं के संचालन के बजाय प्रबंधित बुनियादी ढांचे के लिए भुगतान करना पसंद करते हैं। उन टीमों के लिए, $249-$5,000+/माह की लागत विक्रेता लॉक-इन, सीमित क्वेरी क्षमताओं और अपारदर्शी बुनियादी ढांचे की कीमत पर परिचालन सुविधा खरीदती है।
एआई एप्लिकेशन बनाने वाली अधिकांश टीमों के लिए, NebulaDB स्पष्ट विकल्प है. यह एआई-नेटिव डेटा इंफ्रास्ट्रक्चर के लिए पूर्ण आधार है - ओपन-सोर्स, प्रोडक्शन-रेडी और फ्री।